Привет! Я Дмитрий Дин, тимлид в диджитал-продакшне Далее. Сегодня расскажу, как мы разработали свою BI-систему с гибкими дашбордами и реактивными фильтрами — и для этого я собрал библиотеку ReGraph.
Решение полезно фронтенд-разработчикам, тимлидам, архитекторам — всем, кто работает с динамическими интерфейсами, визуальными конструкторами и кастомной реактивностью.
Моей команде поставили амбициозную задачу — разработать BI-систему для аналитической платформы. С помощью платформы специалисты обрабатывают информацию и статистические данные о рекламных кампаниях.
Мы должны были все свести в единое целое — удобную BI-систему, в которой можно делать отчетность и дашборды для графического представления информации.
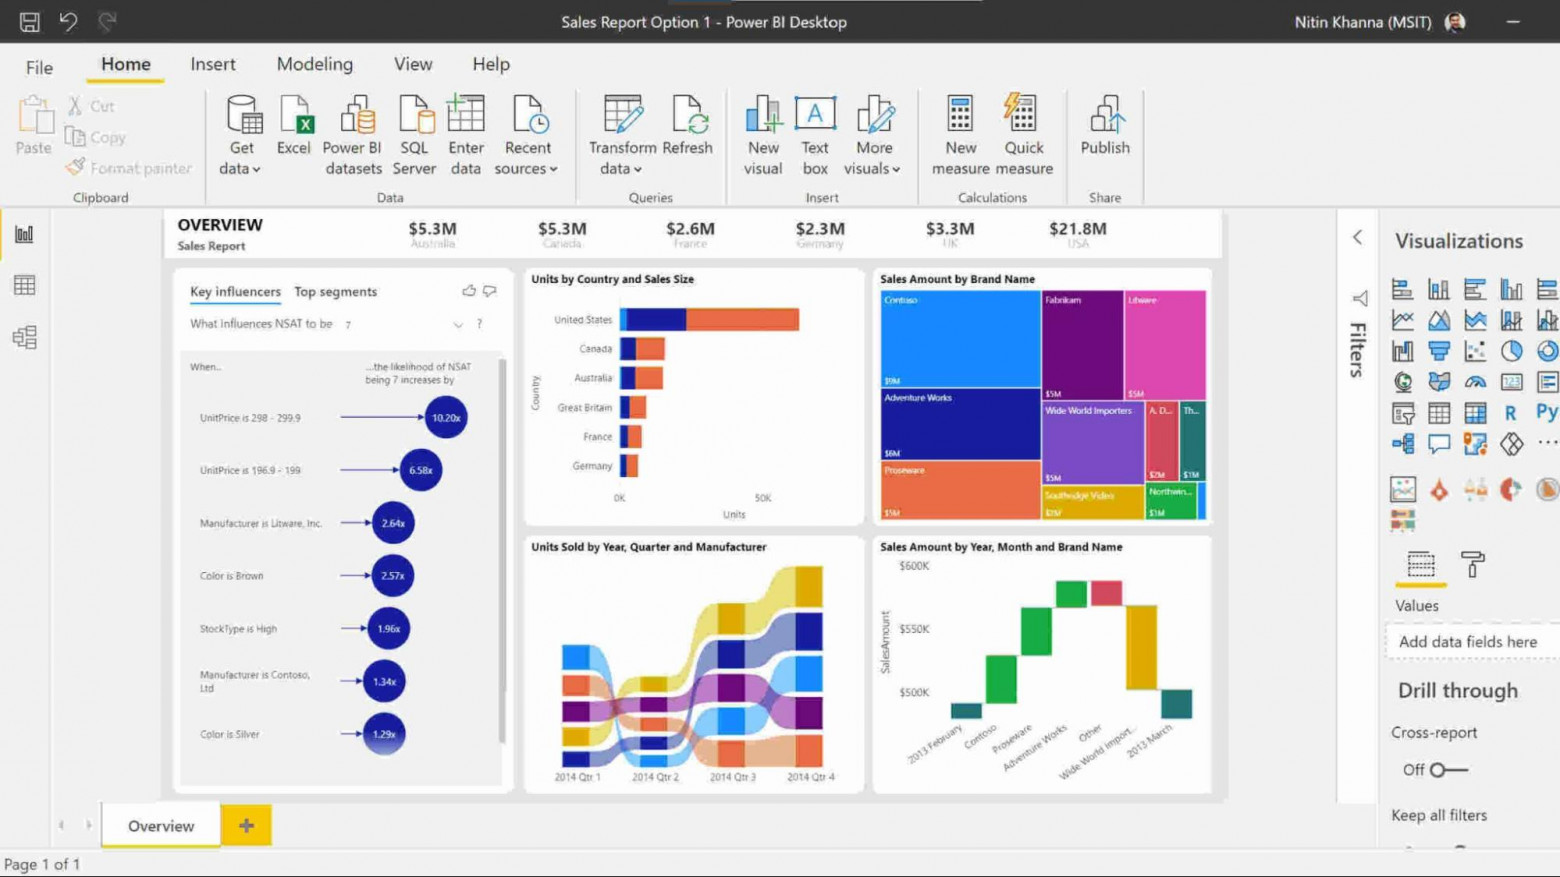
Пример одного из самых известных решений — Power BI от Microsoft. Основной интерфейс — это большая панель с множеством графиков и визуализаций. Такие отчеты можно настраивать вручную: размещать блоки, перетаскивать, группировать и конфигурировать.
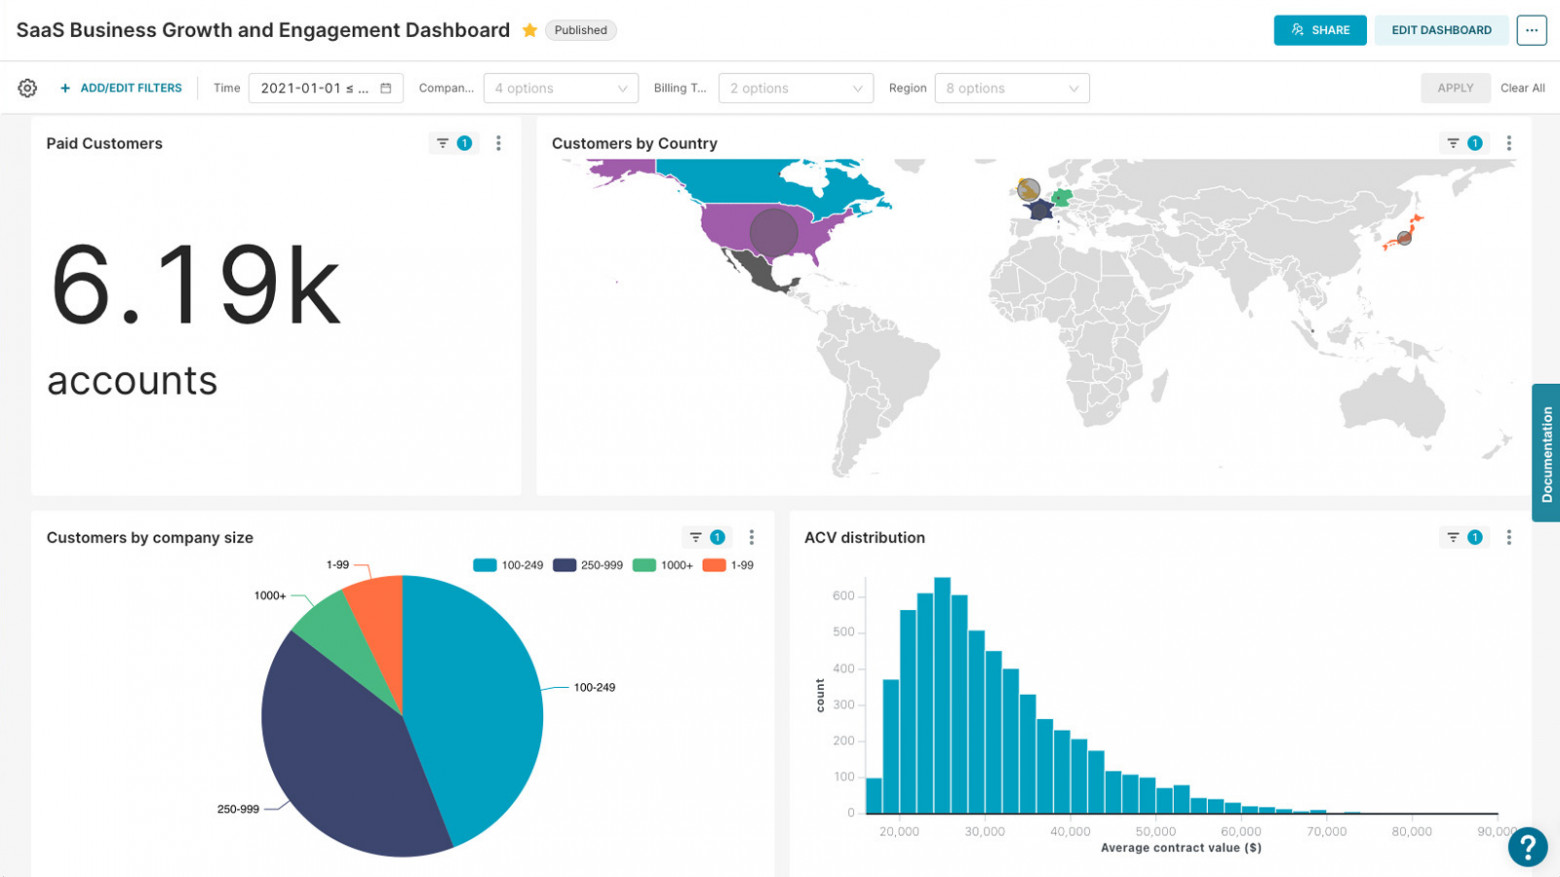
Есть и open source аналог — Superset. Именно его использовали на платформе до кастома. Но Superset хорош для базовых BI-сценариев, а в нашем случае он упирался в ограничения:
-
недостаточность встроенных опций;
-
большие проблемы при обновлении версий без обратной совместимости;
-
сложность кастомизации и интеграции собственных виджетов;
-
плохая поддержка цветовых тем;
-
тяжелый UI для работы менеджеров.
Так мы пришли к созданию собственной BI-системы.
На первый взгляд все это выглядело довольно сложно. И первая реакция на задачу была: «Это же безумие — пилить свою BI-систему!» Но мы рискнули.
Что включает разработка BI-системы
-
Интерактивный холст. Нам нужно было создать интерфейс, на котором размещаются виджеты. Это не просто верстка, а полноценная интерактивная поверхность с позиционированием, возможностью перемещать и настраивать компоненты.
-
Запросы к данным. Мы не говорим про простой SQL-запрос к базе. Требовались более сложные выборки с агрегатами, фильтрами, суммами и логикой.
-
Конфигурация виджетов. У каждого виджета есть своя позиция, размеры, настройки. Виджеты должны «знать», какие данные им нужны, и как эти данные обрабатывать.
-
Реализация самих виджетов. По сути — выбор и подключение библиотеки для построения графиков и таблиц. Здесь важно было соблюсти баланс между гибкостью и производительностью.
-
Сохранение и восстановление дашбордов. Если пользователь собрал дашборд, его нужно сохранить, а потом — восстановить и отобразить в нужном виде.
-
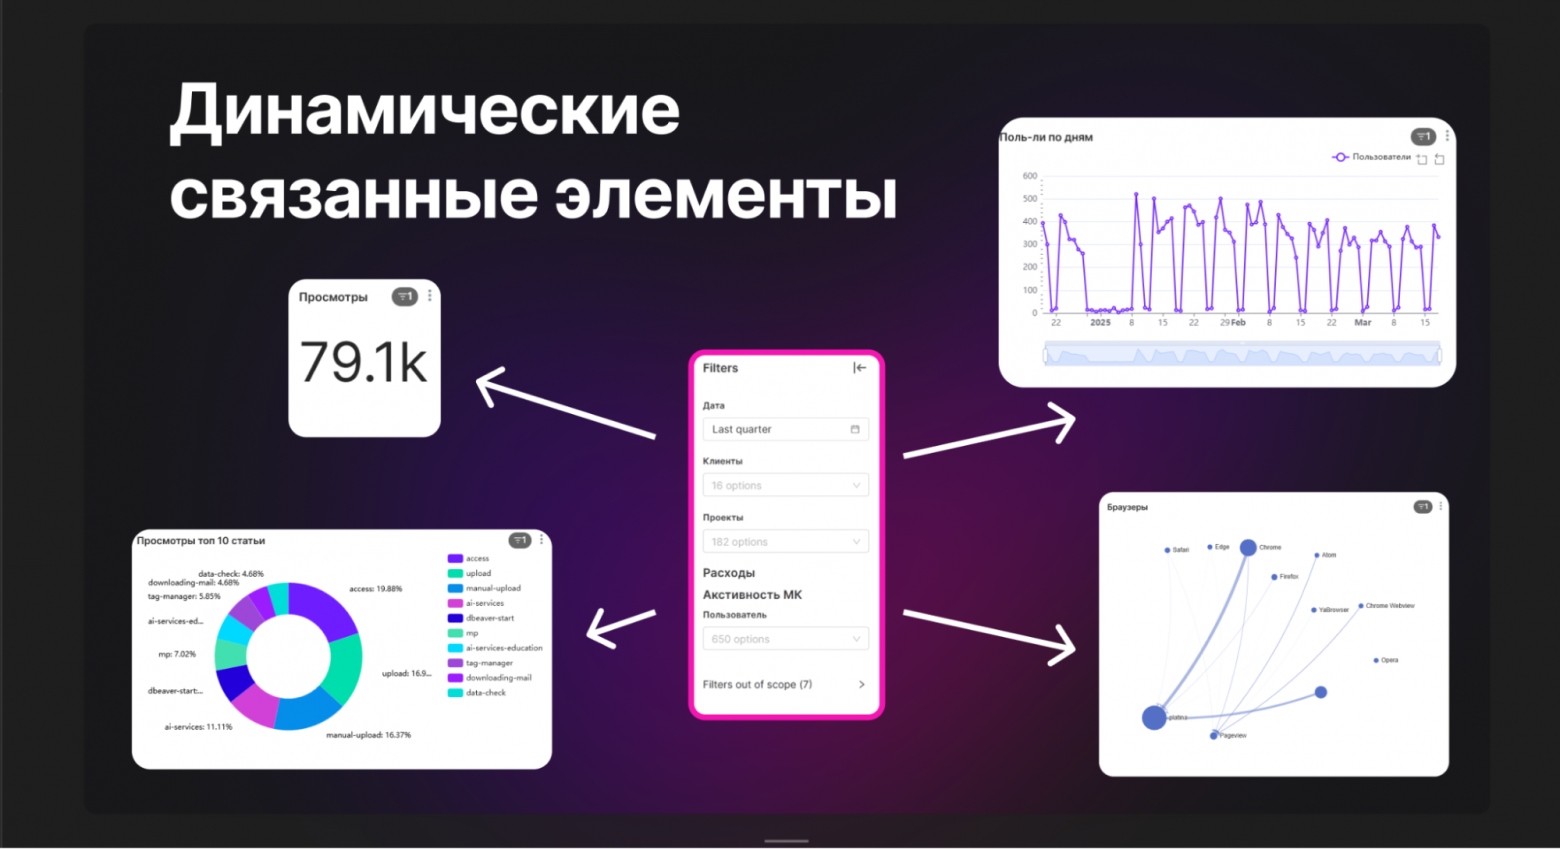
Динамически связанные элементы. Самая сложная часть. Пример — фильтр в центре дашборда, который влияет на все остальные виджеты. Причем таких фильтров может быть несколько, и они могут влиять на разные части отчета по-разному.
Стек для создания BI-системы
У нас уже есть опыт с похожими задачами, поэтому к моменту старта был определенный стек, на который мы могли опереться.
Во главе всего — Svelte. Мы активно его используем в наших проектах. Он предоставляет великолепный DX, что положительно сказывается как на продуктивности, так и на удовлетворенности разработчиков.
Для построения графиков — eCharts. Он хорошо себя показал: гибкий, быстрый, с большим количеством встроенных типов визуализации.
Для коммуникации с backend — мой собственный фреймворк «чёрт» (Chord). И да, я в курсе, что по-английски правильно говорить «корд», но как автор оставляю за собой право произносить «чёрт» — просто потому, что так забавнее 😜
В качестве ORM взяли Prisma. А еще нашли полезную библиотеку — Svelte Flow. Она помогает создавать интерактивные холсты: размещать и позиционировать элементы, реализовывать перетаскивание — прям как в Miro!
Но один вопрос остался открытым: как решать задачу с динамически связанными элементами? Готового ответа у нас не было. Пришлось копать глубже — в сторону реактивности.
Подходы к реактивности — смотрим Redux, RxJS и Effector
Реактивность — это способность системы подстраиваться под входной поток изменяющихся данных. Входной поток — это последовательность событий: клики, нажатия клавиш, любые пользовательские действия и прочие изменения.
Существует два основных типа реактивности:
Pull-реактивность — когда подписчик сам запрашивает актуальные данные, то есть вытягивает их на себя.
Push-реактивность — когда система отправляет новые значения подписчикам, как только они появляются.
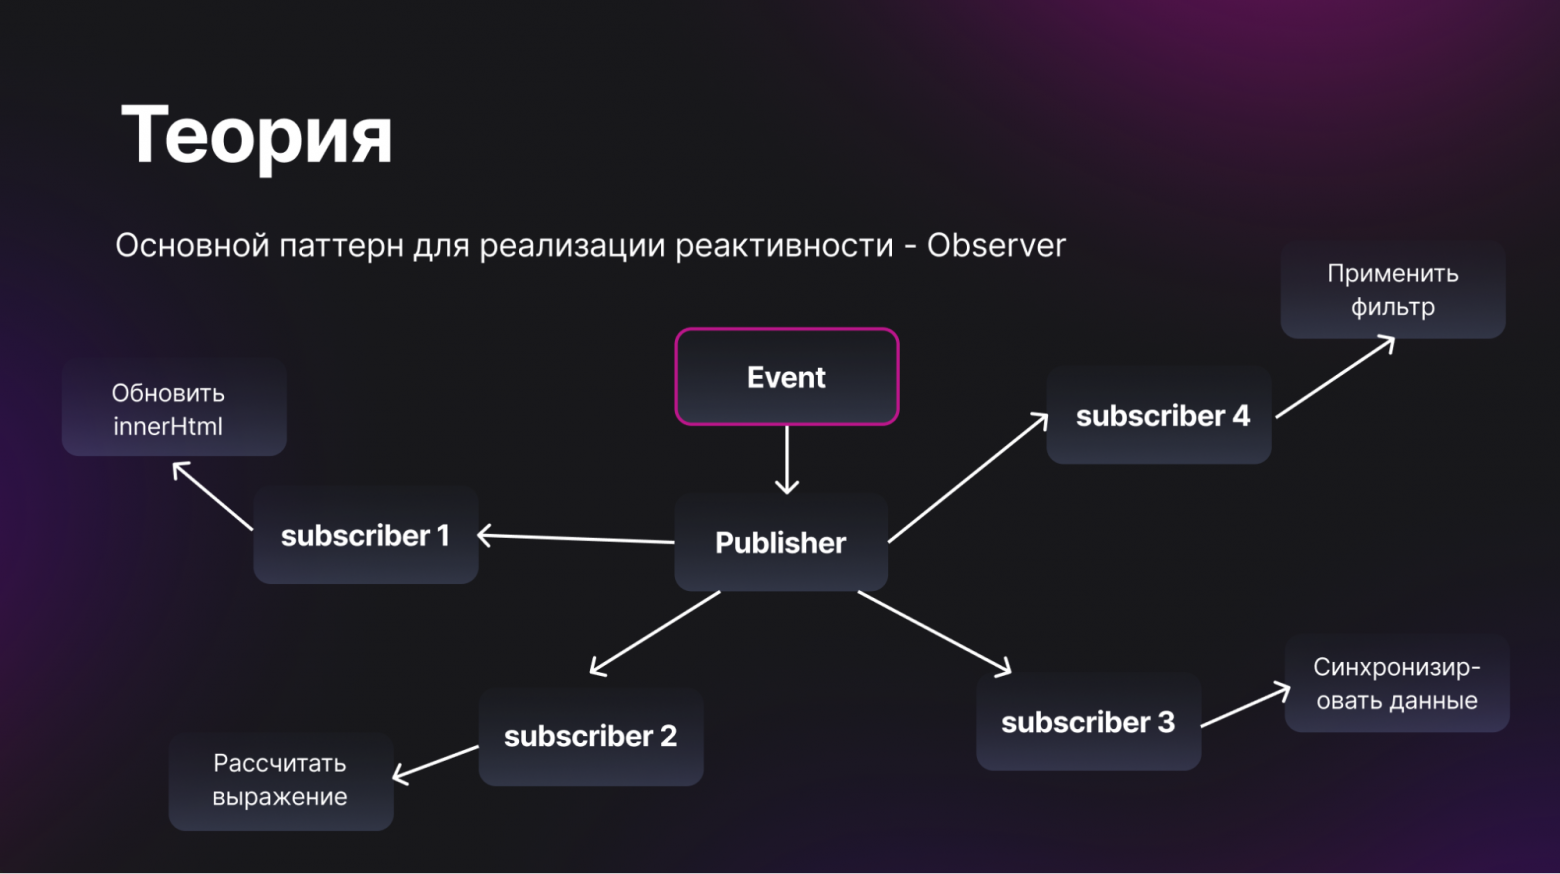
Основной паттерн, на котором все это основано, — Observer. Пример: к нам поступает событие, оно уходит в паблишер, и тот рассылает уведомления подписчикам. Каждый подписчик выполняет свою задачу: кто-то обновляет интерфейс, кто-то делает запрос на бэкенд, кто-то что-то рассчитывает.
В Redux у нас есть:
-
начальное состояние (initial state), которое мы передаем в store;
-
экшены, с помощью которых мы меняем состояние;
-
подписки, которые следят за обновлениями.
Раньше API Redux выглядело довольно громоздко — много switch/case внутри редьюсеров. Сейчас оно стало чуть чище, но по сути остается тем же.
Минусы Redux — это моностор без производных выражений и встроенных эффектов. API довольно примитивный и не слишком удобный.
RxJS — это реализация push-реактивности. Мы работаем с потоками данных. Есть Observable — источник, и есть Observer — подписчик, который реализует методы next, error и complete.
Подписка оформляется явно: мы подписываем Observer на Observable и начинаем получать данные.
RxJS позволяет объединять потоки: есть возможность собрать несколько Observables в один, и дальше вычислять производные значения. Это мощно, но требует определенного входа — порог чуть выше.
Effector — еще один интересный инструмент. В целом, он реализует похожие концепции: у нас есть сторы, ивенты, подписки.
Можно вызывать события, которые меняют стор, можно подписаться на изменения с помощью watch, можно запускать эффекты (например, API-вызовы), можно создавать derived-состояния.
Но это не сигналы
Слегка затронем тему сигналов, потому что все перечисленное выше — не совсем сигналы в привычном понимании. Когда говорят «сигналы», обычно имеют в виду минимальный, унифицированный API, который включает:
-
стейты,
-
производные стейты (derived),
-
эффекты.
Большинство современных фреймворков, которые мы знаем, уже так или иначе адаптируются к сигналам, но не полностью. Также существует пропозал, который предлагает добавить сигналы в натив веба.
Реактивность в Svelte
В Svelte 4 есть сторы — это writable, readable, derived и так далее. Они работают достаточно просто: чтобы изменить значение, мы вызываем методы set или update. После этого автоматически срабатывают подписки.
Здесь вы можете видеть два метода, которые реализуют каунтер простой и изменяют Store.
Также мы можем создать, как и в других библиотеках, Derived-состояние. Мы аккумулируем два Store в один и пересчитываем каждый раз, когда любое значение из двух Store изменяется.
В Svelte 5 появились руны (runes). Это новое, более чистое и нативное API для работы с реактивностью.
Здесь мы используем обычный JS — никаких $, subscribe, set. Все значения обновляются автоматически, при этом API остается декларативным и понятным.
Это уже больше похоже на сигналы — такие же state/derived конструкции, только более интегрированные в фреймворк. И, что важно, они не завязаны так сильно на компиляции, как reactive declarations в Svelte 3 и 4, и их можно порождать в фабриках.
Проблема — динамические состояния
После того как мы разобрали разные подходы, возникает закономерный ряд вопросов — Все библиотеки умеют работать с состояниями, но…
-
Что если нам нужно создавать состояния динамически, прямо в рантайме?
-
Что если мы не можем заранее захардкодить зависимости между компонентами?
-
Что если нам нужно построить реактивную систему на лету, а не через статические импорты и декларации?
Эти вопросы особенно актуальны для BI-систем, где пользователь может в любой момент добавить фильтр, связать его с конкретным графиком или таблицей, а потом сохранить все это и восстановить позже.
В большинстве существующих инструментах все это надо прописывать вручную, хардкодить связи или городить надстройки над стор-менеджерами. Нам нужно было, чтобы вся реактивная логика собиралась автоматически и динамически по ходу жизненного цикла дашборда.
Самая сложная часть задачи, которую мы поставили себе — это динамически связанные элементы, фильтры. Именно они задали тон всей архитектуре будущего решения.
Решение — кастомная ReGraph
Чтобы закрыть задачу с динамическими связями, я разработал собственную реактивную систему поверх Svelte 4 — ReGraph. По сути, это реактивный Graph, где:
-
Graph — это синглтон-объект, к которому можно в любой момент обратиться и получить любую ноду;
-
ноды — это реактивные элементы, каждый из которых содержит три состояния: input, computed и output;
-
ребра — связи между нодами, которые позволяют передавать данные и подписки.
Что дает ReGraph
В отличие от готовых BI-платформ вроде Superset или классических стейт-менеджеров, наша система на ReGraph не ограничена заранее заданной структурой. Все строится динамически: фильтры, виджеты, связи между ними.
-
Больше гибкости. Любой элемент можно добавить, связать или удалить на лету.
-
Меньше кода. Вместо сотен строчек ручной логики — несколько декларативных вызовов, описывающих граф зависимостей.
-
Выше производительность. Нет тяжелого слоя абстракции: Graph реагирует мгновенно, даже при десятках связанных компонентов.
-
Легко масштабировать. Новые Nodes и Edges добавляются без изменения архитектуры — граф сам подстраивается.
-
Удобно сохранять и переносить. Весь дашборд сериализуется в JSON, который можно восстановить в любом окружении.
-
Польза для бизнеса — быстрое создание кастомных дашбордов.
На основе этого решения мы построили архитектуру BI-системы, в которой любая нода может быть создана в любой момент, связана с другими — и все работает так же, как если бы это был статически определенный стор.
Упрощенный код реализации конструктора для каждой ноды:
Здесь у нас Singleton Graph. Мы инициализируем его и передаем сразу в Svelte Context, аналогично React Context. Это позволяет в любом компоненте получить доступ к текущему Graph и обратиться к нужной ноде. Помимо этого, есть другие CRUD методы для работы с нодами.
Первый тест: кастомный отчет
Первым полигоном для ReGraph стал кастомный отчет — один из модулей нашей платформы. Интерфейс по функционалу похож на Яндекс.Метрику.
Получился статичный отчет: все компоненты были прибиты гвоздями, никакой динамики, только фиксированная верстка и фиксированные зависимости.
Тем не менее, даже в этих условиях нам удалось протестировать ключевые принципы:
-
вместо ручной подписки компонентов друг на друга мы связали их через Graph;
-
применили реактивность ReGraph внутри всех связей;
-
убедились, что даже в жесткой структуре Graph работает корректно.
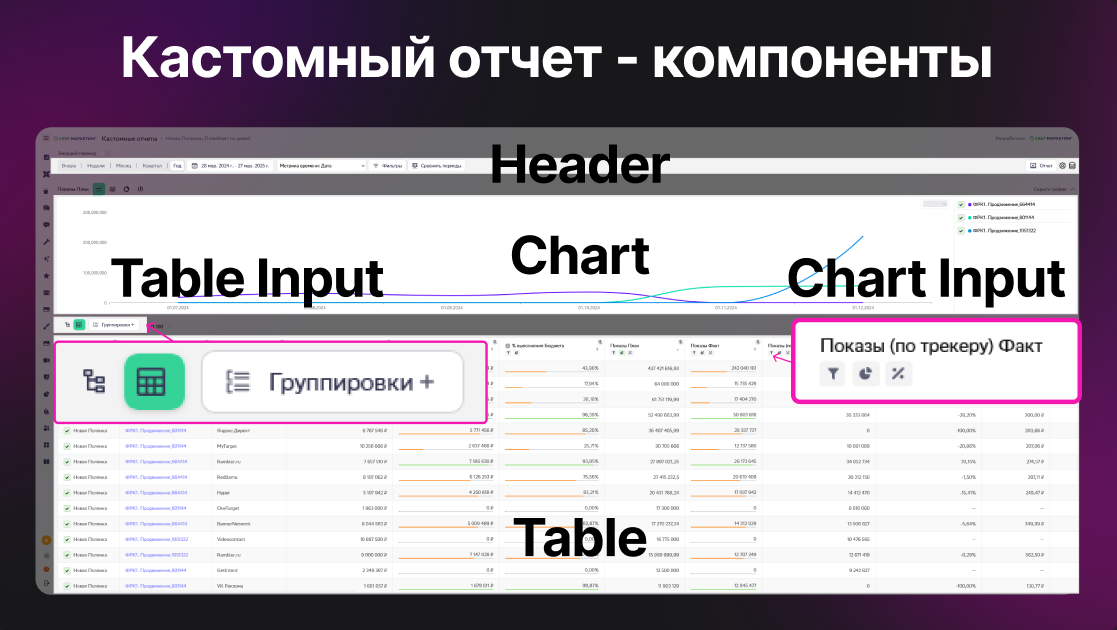
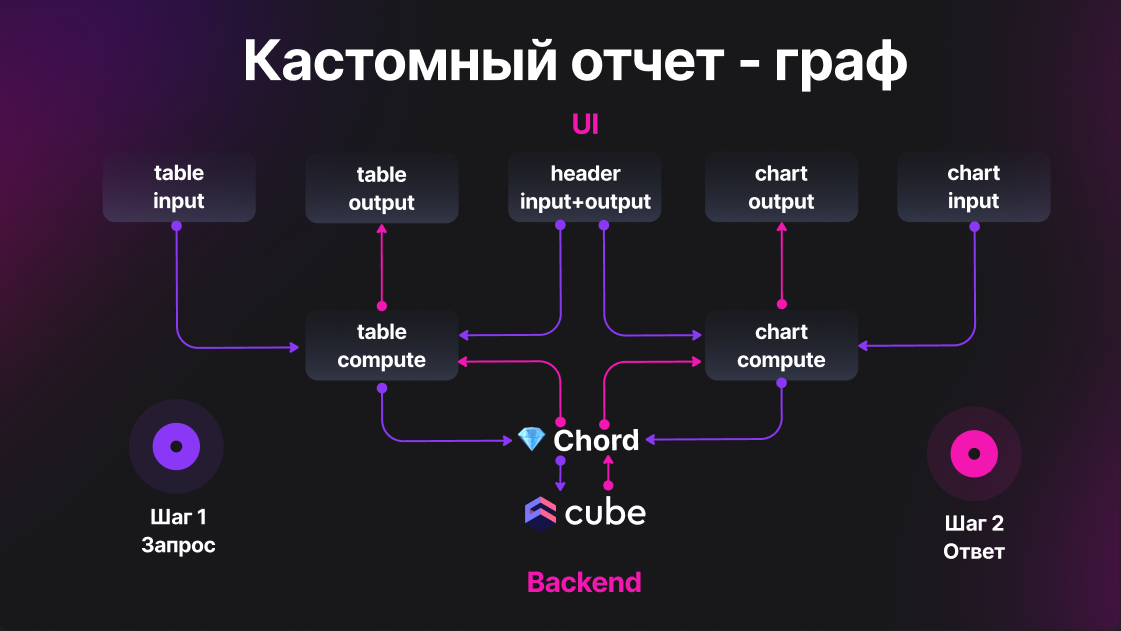
На иллюстрации можно увидеть, как это выглядело в терминах ReGraph: каждый компонент — отдельная нода с тремя состояниями. Все ноды связаны друг с другом через edges (подписки), и при изменении одной данные автоматически обновлялись во всех зависимых.
Выводы после теста
-
Графовая модель отлично легла на Кастомный отчет.
-
Виджеты удобно инкапсулируются в нодах.
-
Данные можно доставать из Graph в любой момент.
Но мы не проверили две вещи:
-
динамические подписки во время рантайма;
-
сохранение/восстановление Graph в JSON — все было статично и жестко зашито.
Теперь переходим к рабочей версии BI-системы, где мы уже полностью раскрыли потенциал ReGraph и задействовали все фичи.
Реализация BI-системы
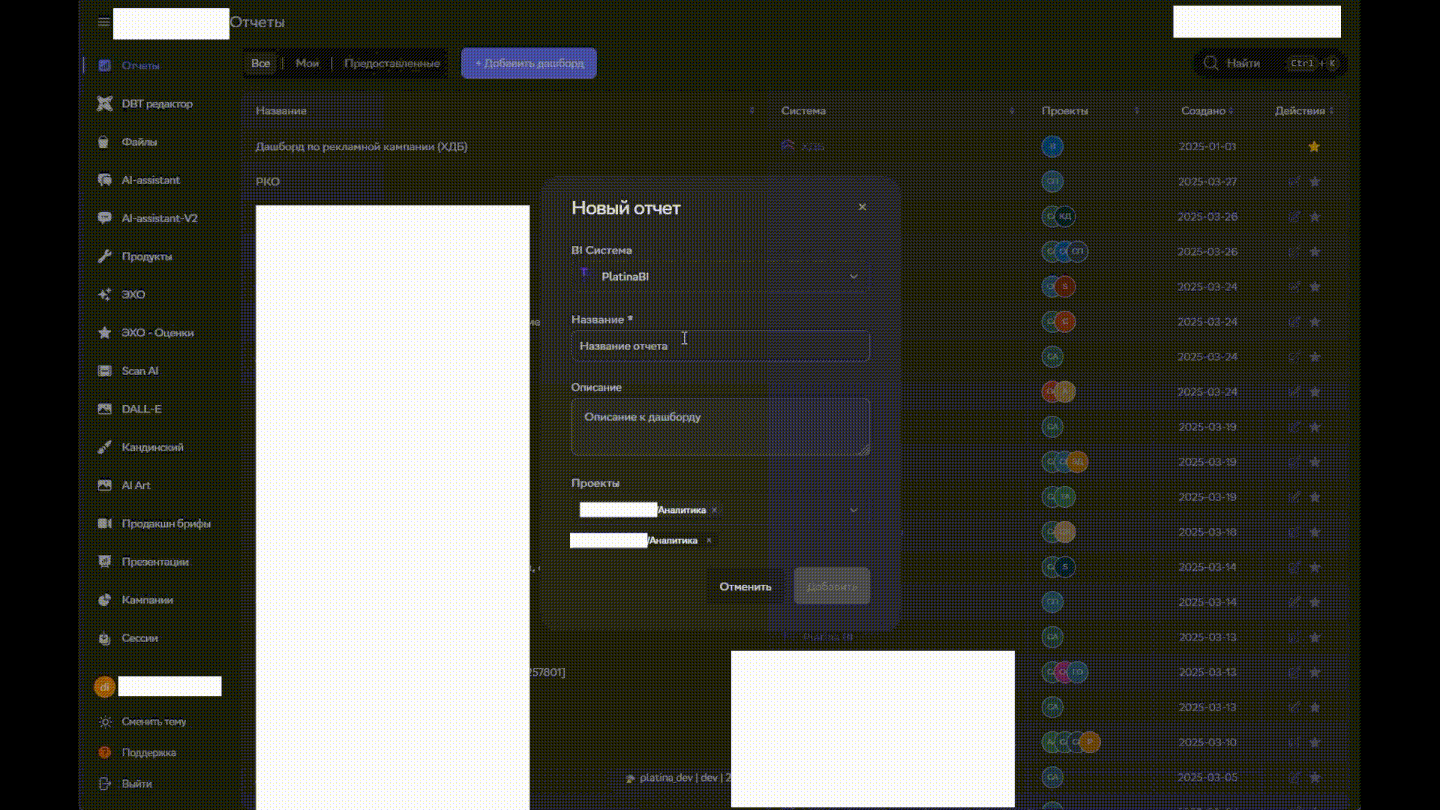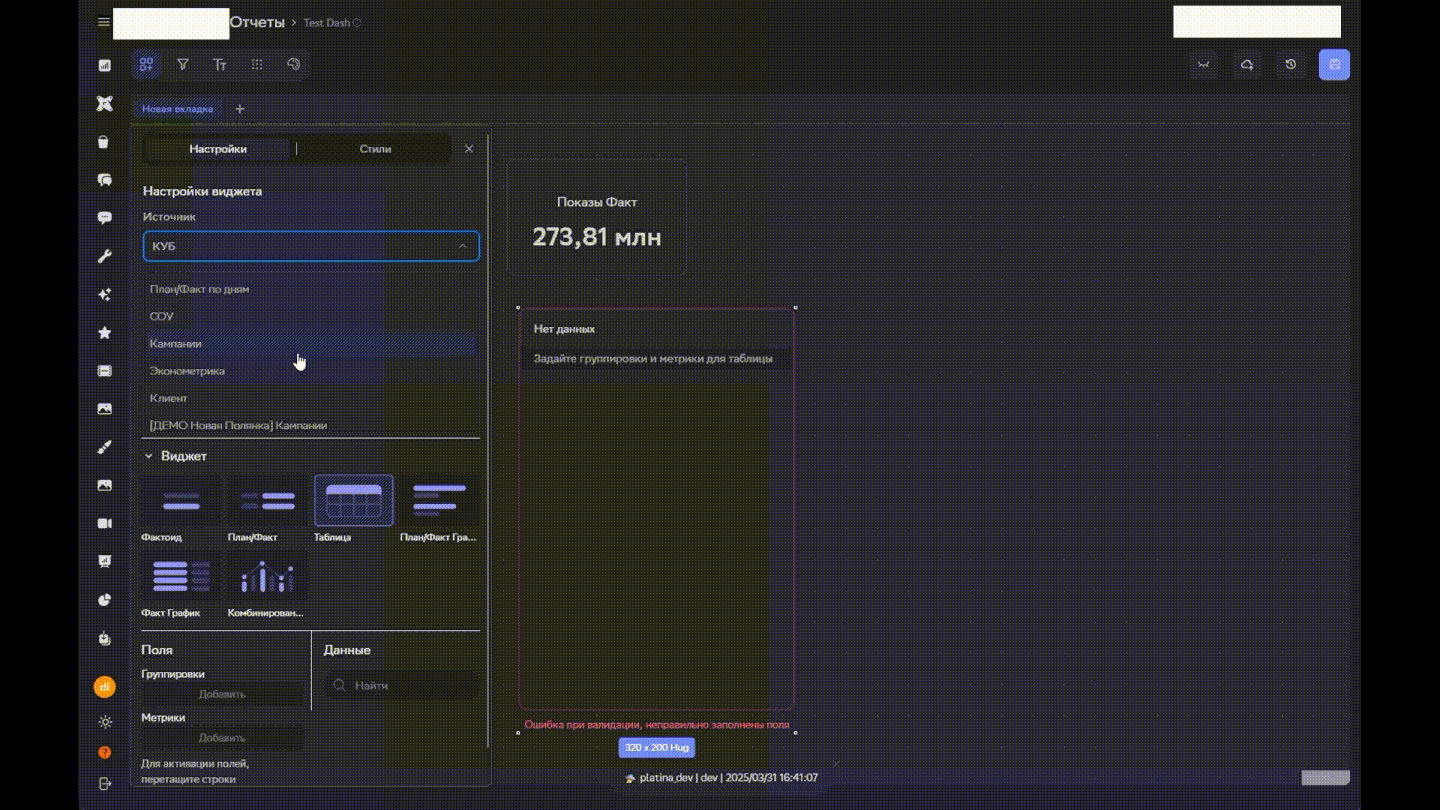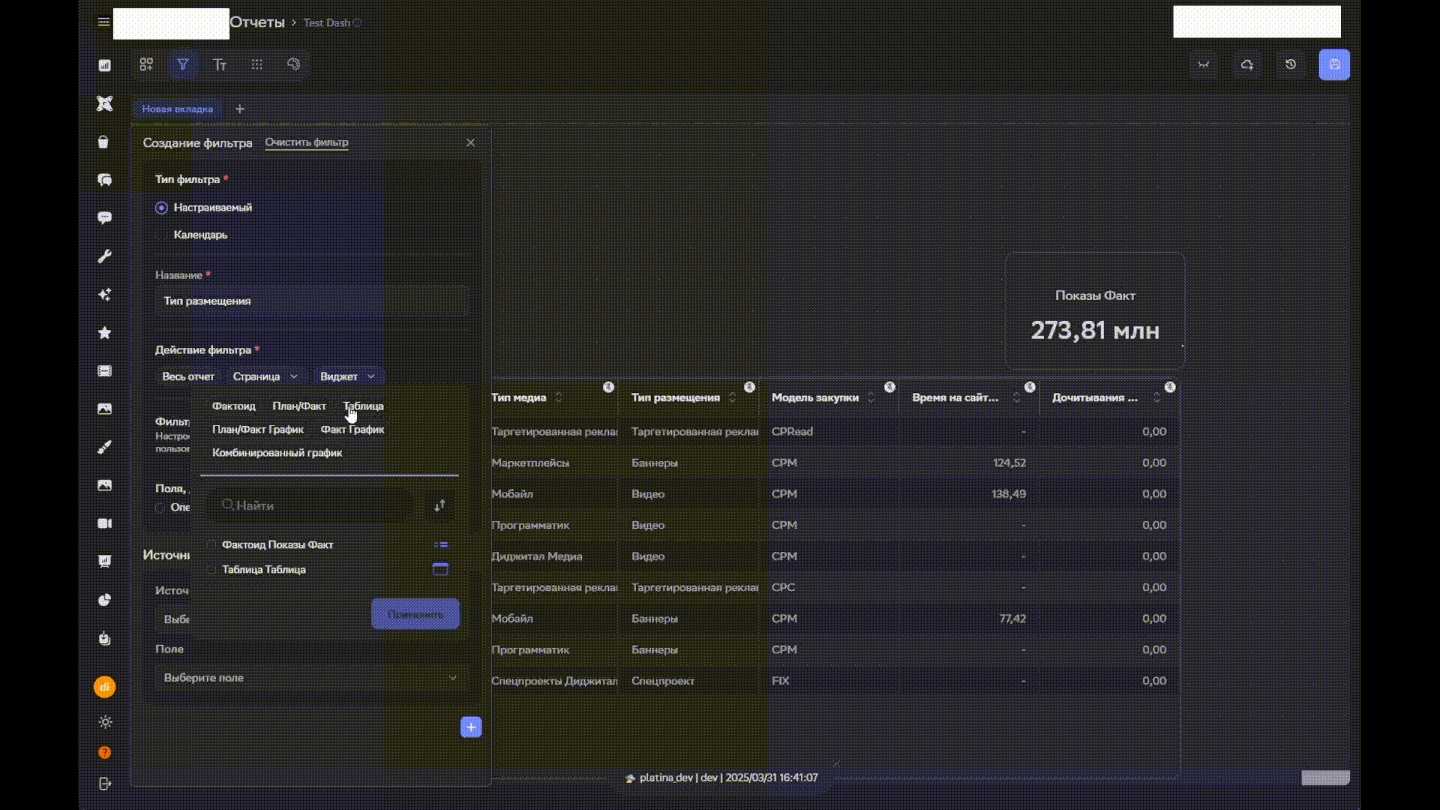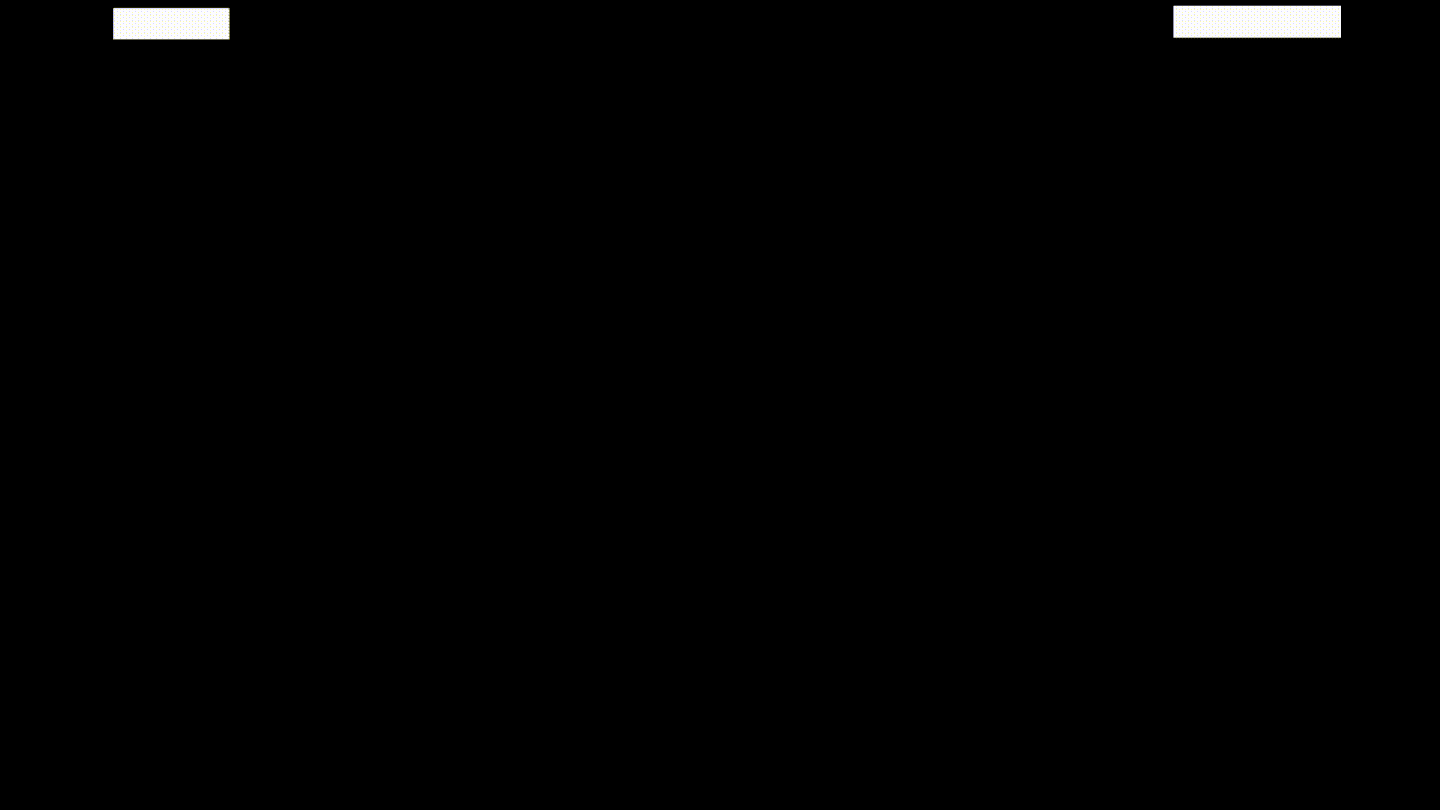
После успешного теста на кастомном отчете мы приступили к усиленной разработке BI-системы. На этот раз уже с динамикой, конструктором и полноценной интеграцией ReGraph.
Все устроено так:
-
Пользователь создает дашборд.
-
Добавляет на холст виджеты — таблицы, графики, фильтры.
-
Каждому виджету соответствует своя нода в Graph.
-
В зависимости от связей между виджетами ReGraph выстраивает цепочки реактивности.
BI-дашборд, который в итоге мы собрали содержит:
-
комбинированный график,
-
несколько factoid-виджетов,
-
таблицу,
-
три фильтра — два глобальных и один локальный.
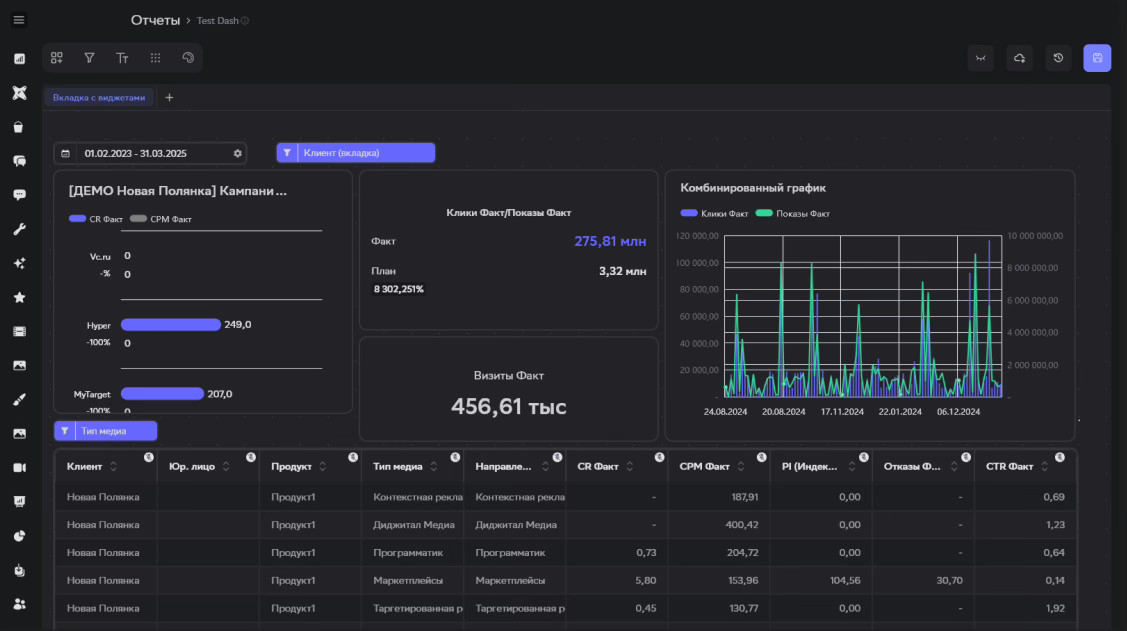
В абстрактном виде на уровне нод Graph выглядит так:
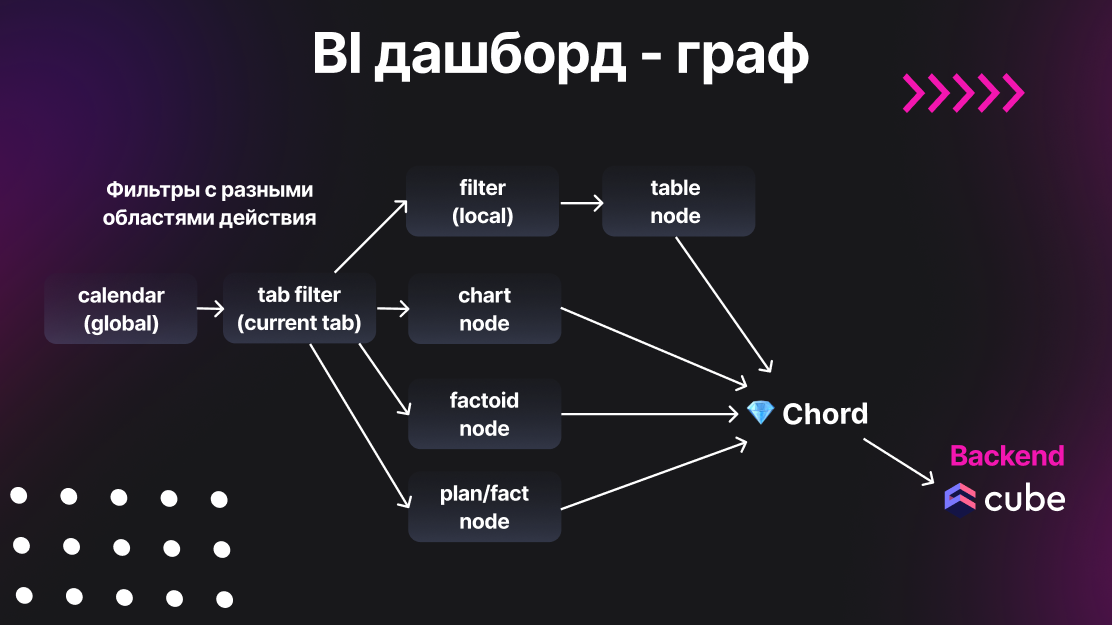
Видно, что у нас есть композиция фильтров из календаря, есть фильтр вкладки, который был сверху в углу — фиолетовый. Дальше он перетекает в локальный фильтр, который применяется только к таблице. И после этого значения подставляются таблицу. Запросы отправляются через Chord в CubeJS.
Другие виджеты работают аналогичным образом, за тем исключением, что у них нет локальных фильтров, как у таблицы. То есть они работают уже сразу напрямую с двумя фильтрами без посредников. И таким образом у нас данные перетекают слева направо, и все реактивно обновляется.
Сохранение и восстановление виджетов
Теперь разберем немного то, как у нас работает сохранение виджетов, так как я говорил, что мы еще не тестили эту фичу. Вот здесь уже есть код, который как раз это реализует.
Все просто. Пробегаемся по Graph, итерируемся по всем нодам, из каждой ноды извлекаем ее input-состояние и собираем это в удобную для нас JSON-структуру.
Такой JSON можно хранить в базе или на клиенте, и он будет отражать текущую структуру дашборда — со всеми связями и параметрами.
Чтобы восстановить дашборд, читаем сохраненный JSON. Создаем новые ноды на его основе и передаем input-данные из сохраненного состояния — Graph сам восстанавливает связи и подписки.
Это решение полностью отвязывает реактивность от кода: все поведение можно сохранить, отложить и поднять позже, без участия разработчика. Причем все связи останутся на месте — никаких addEventListener, никаких ручных subscribe.
Что смогли достичь
За два месяца наша команда собрала рабочую BI-систему поверх ReGraph. В цифрах и фактах это выглядит так:
-
Скорость разработки — новые виджеты и фильтры подключаются за часы, а не за недели.
-
Кодовая база — вместо сотен строк ручной логики зависимости описываются в 2–3 декларативных вызовах.
-
Реактивность — любое изменение в фильтре прокатывается по графу автоматически, без ручных subscribe и «забытых» обновлений.
-
Масштабируемость — рост числа виджетов не увеличивает сложность кода: Graph остается единым, добавляются только новые Nodes и Edges.
-
Портируемость — все состояние хранится в JSON, что позволяет легко сохранять и восстанавливать дашборды, переносить их между окружениями и тестировать конфигурации.
Перфоманс — за счет точечных обновлений по месту, там где это необходимо, отклик интерфейса остается «живым» даже при множестве связей и фильтров.
Где еще можно использовать ReGraph
Хотя изначально ReGraph создавалась под задачи BI, ее архитектура хорошо ложится и на другие кейсы. Есть несколько направлений, где можно применить систему.
1. Конструкторы ботов
Если вы строите визуальный интерфейс для проектирования диалогов — ReGraph может выступать как движок, описывающий логику переходов между состояниями. Каждое состояние — нода, связи между ними — Edges.
2. Динамические опросники
Формы, которые подстраиваются под ответы пользователя на лету. Например: если пользователь выбрал «юридическое лицо», появляются поля про ИНН и КПП — это можно выразить через динамические ноды и связи между ними.
3. Web Audio API
Браузерное API для работы со звуком тоже построено на графах: фильтры, осцилляторы, компрессоры. ReGraph можно адаптировать для построения сложных звуковых цепочек, где каждая нода — это аудио-нода с параметрами и входами/выходами.
Конечно, этим список не ограничивается. Вы можете использовать ReGraph для своих специфических задач.
Рецепт: как приготовить ReGraph самому
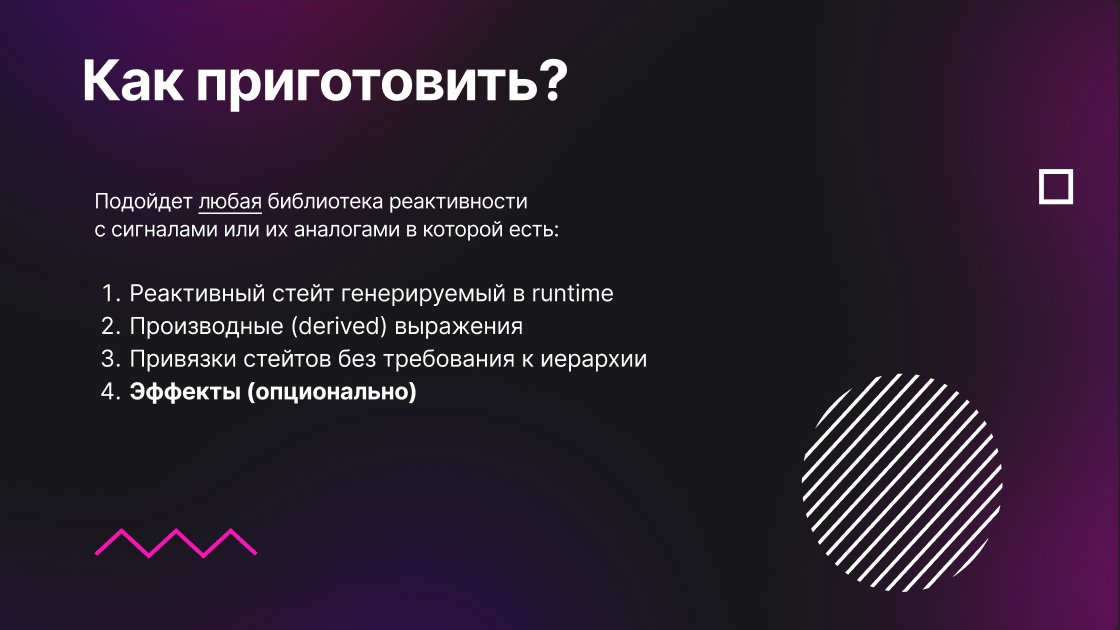
Если вы захотите реализовать ReGraph самостоятельно, то ниже — минимальные требования к фреймворку или библиотеке, на которой это можно сделать.
1. Поддержка динамических состояний
У вас должна быть возможность создавать состояния (сторы, сигналы и т.п.) не в compile-time, а в рантайме. Это исключает, например, реактивность в Svelte через let и $: — она статична. Подойдут store-based или signal-based системы.
2. Derived-состояния
Вы должны уметь объединять несколько состояний в производное, которое автоматически обновляется при изменении любого из источников. Это нужно для compute в ноде.
3. Отсутствие иерархии состояний
Если библиотека требует иерархическое расположение состояний, например, React с его хуками, это может мешать. Нам нужна глобальная управляемость — возможность свободно добавлять и связывать ноды в любом порядке.
4. Поддержка эффектов
Необязательный, но желательный пункт. Эффекты (реакции на изменение состояний) сильно упрощают код и позволяют реализовывать подписки, обновления интерфейса, запросы к API и прочие побочные действия.
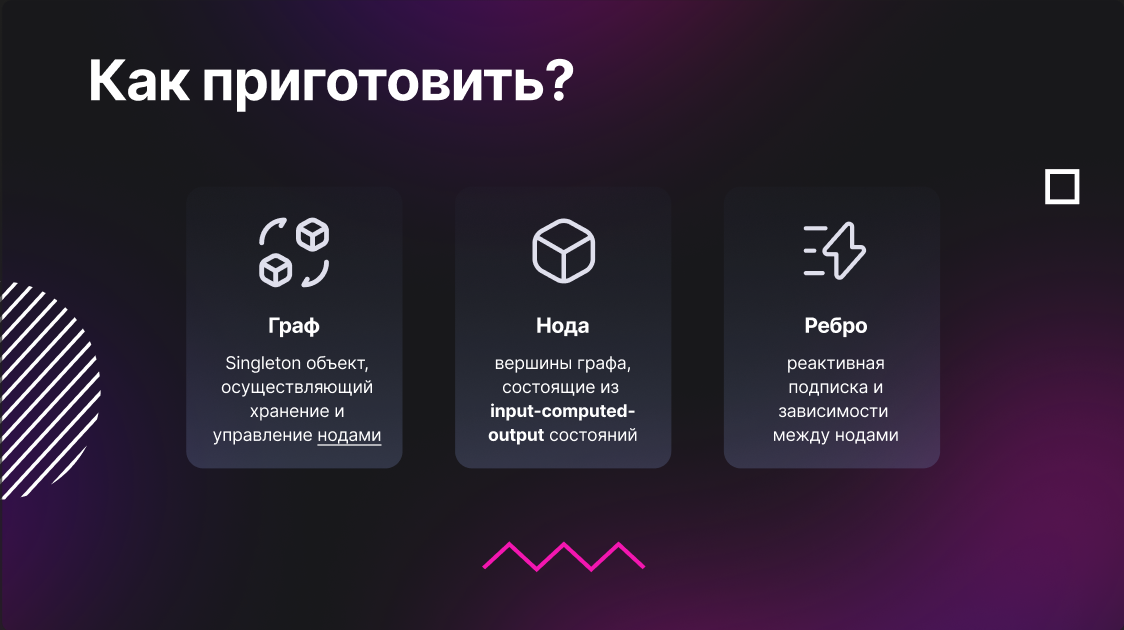
Все должно быть сведено воедино: Graph как синглтон, набор нод и ребра — связи между ними. Именно такая архитектура делает ReGraph универсальной и переносимой.
Демо
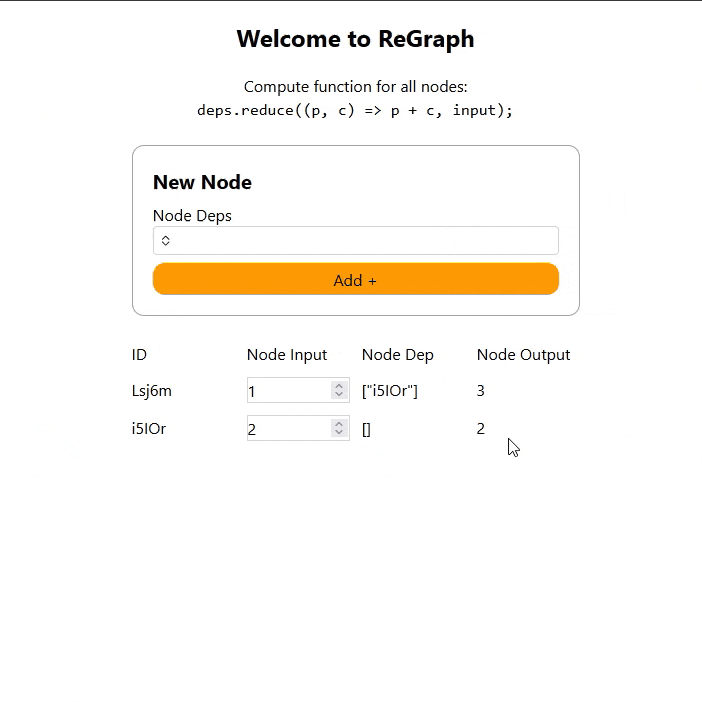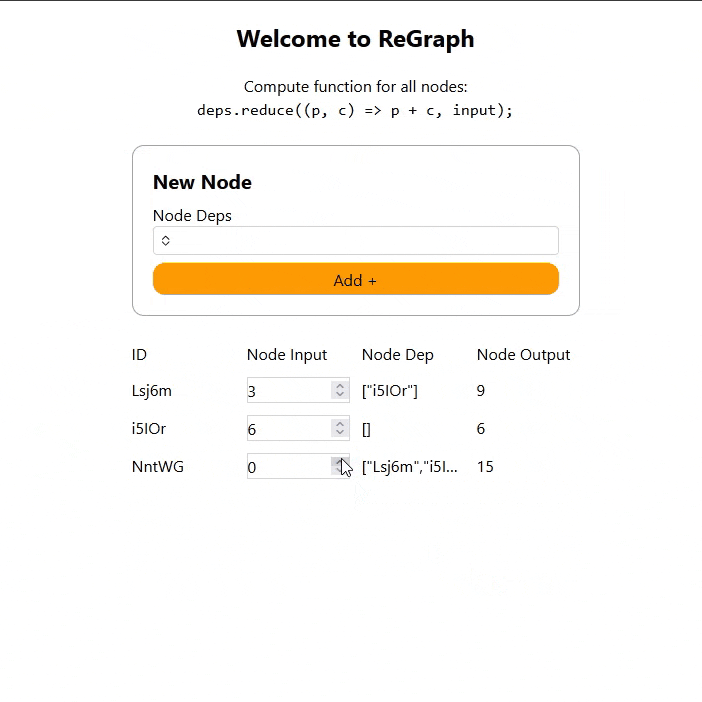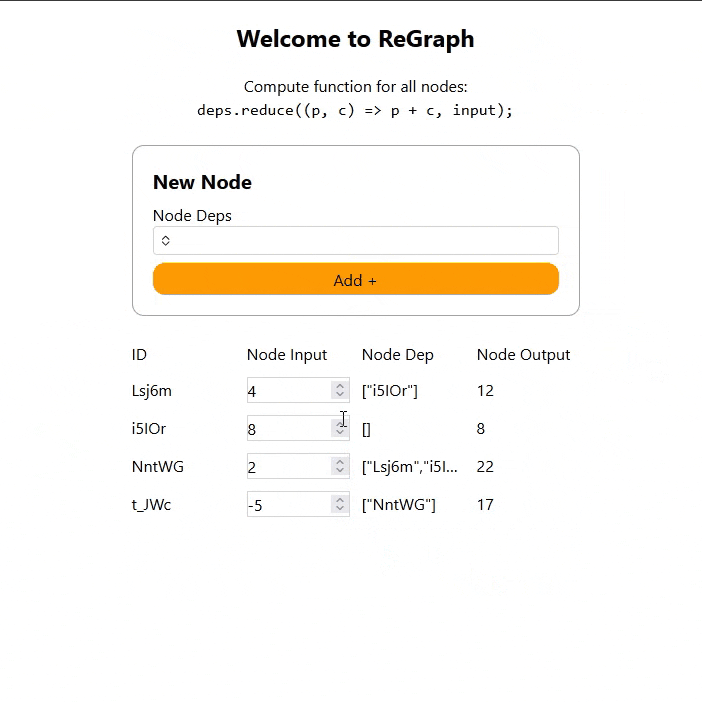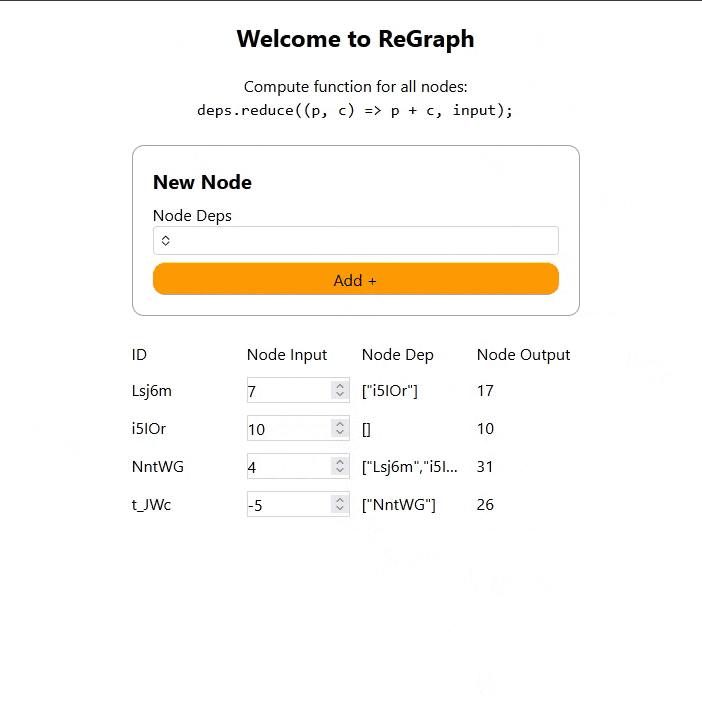
Это простое приложение на ReGraph — сумматор: вы создаете ноды, связываете их — и они начинают автоматически суммировать входные значения. Все это работает в браузере и в реальном времени.
А здесь находится репозиторий с демо-реализацией ReGraph на Svelte 5. Это не полноценная библиотека, скорее MVP: код, который можно пощупать, запустить у себя и адаптировать под свои задачи.
Я надеюсь, что теперь вы взглянете иначе на реактивность. Состояния — это не обязательно switch/case, экшены и subscribe.
Иногда вместо того чтобы городить реактивную логику вручную, стоит посмотреть на задачу как на граф, и тогда этот подход поможет вам приручить собственные сигналы.
Есть идеи, для которых готовы попробовать собрать свою систему реактивности? Делитесь ими в комментариях и рассказывайте, над какими кастомными решениями приходилось работать самим.